当大模型指挥 VLA:Harness VLA 在 Franka FR3 真机上的部署与对比评测
0:00
/1:36
VLA 很擅长"把这个东西抓起来放过去",但听到"把桌上的蔬菜放进蓝盘"这种需要理解类别、拆分步骤的指令时,经常抓错。2026 年很热的一条思路,是让大模型做规划、VLA 做执行。这个项目里,我把 Harness VLA 部署到 Franka FR3 真机上,和纯 VLA 做了同条件对比:真机成功率 14/15,高于纯 VLA 的 11/15。
一、为什么做这件事?
从 2023 年做 GLM-4V 控制机械臂开始,我一直在做"大模型控制机器人"。当时大模型只能做规划,动作要靠手写的原语;现在 VLA 能直接输出连续动作,但语义理解和长任务拆解又成了短板。
Harness VLA 的做法是把一个冻结的 VLA 当成工具,交给大模型 Agent 编排:大模型看图、找目标、决定什么时候调用 VLA。论文的定量结果都在仿真基准上,我想知道的是:换到真机、换一个 VLA,这套分层到底在哪些任务上有用。
二、真机平台与系统搭建
| 层级 | 组件 | 职责 |
|---|---|---|
| 规划器 | DeepSeek 大模型 | 看图识别目标、拆解任务、选择工具、判断是否完成 |
| 工具层 | RPent 框架 | 读取状态和图像、像素反投影到机械臂坐标、小步移动和旋转、开合夹爪、调用 VLA |
| 执行器 | π0.5 VLA(实验室提供的 FR3 权重) | 接收一句短指令,在局部完成抓取和放置 |
| 硬件 | Franka FR3 + Robotiq 2F-85 + 腕部和侧边两台 D405 | 真机执行与感知 |
我独立完成了这套系统的真机部署:打通框架和模型服务,接入两路相机,完成手眼标定。侧边相机三次采集共 32 个位姿,留一法误差 0.47 mm / 0.06°。
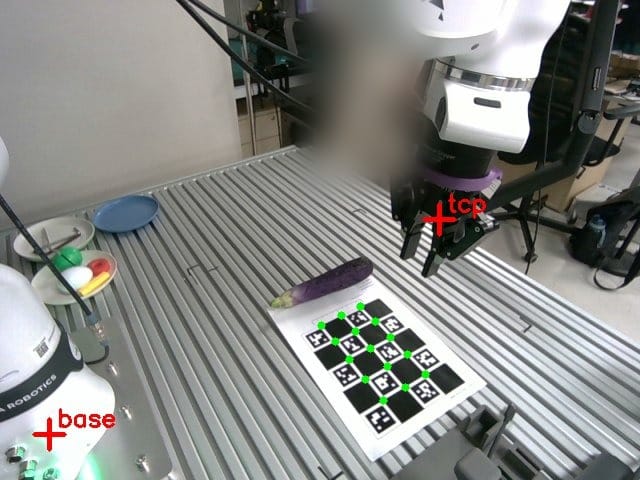
图1 侧边 D405 手眼标定检查
三、评测设计:三类任务,各 5 次
两种方式从同一个初始位姿出发,用同一个 VLA 权重:
| 任务 | 指令 | 考察点 |
|---|---|---|
| 任务 1 | 把茄子放进蓝盘 | 单物体 |
| 任务 2 | 先把网球放蓝盘,再把茄子放白盘 | 多步骤 |
| 任务 3 | 只把蔬菜放进蓝盘(桌上还有网球和白球) | 类别理解 |
纯 π0.5 直接接收整句指令;Harness VLA 由规划器拆解后,再分段调用 VLA。
四、结果:14/15 vs 11/15
| 任务 1 | 任务 2 | 任务 3 | 合计 | |
|---|---|---|---|---|
| 纯 π0.5 | 5/5 | 3/5 | 3/5 | 11/15 |
| Harness VLA | 5/5 | 4/5 | 5/5 | 14/15 |
几个关键发现:
- 类别任务差距最大:纯 π0.5 两次失败都是把球当成了"蔬菜"放进盘子;Harness VLA 的规划器先认出茄子并把机械臂移到它上方,再让 VLA 去抓,5 次全部成功。
- 多步骤任务更稳:纯 π0.5 的失败都出在第二步的茄子上;规划器拆分步骤后,4/5 成功。
- 单物体任务两者持平:都是 5/5。这类任务 VLA 自己就能完成,规划器看图定位反而会增加用时(成功回合用时中位数 189.7 s 对 46.6 s)。
结论:分层控制在语义理解和多步骤任务上优势明显;简单任务直接交给 VLA 更高效。
五、成果
- ✅ 真机部署:在 Franka FR3 上独立跑通"大模型规划器 + π0.5 VLA"分层控制,包括双相机接入和手眼标定(0.47 mm / 0.06°)
- ✅ 对比评测:设计 3 类任务、每类 5 次的同条件真机对比,成功率 14/15,高于纯 VLA 的 11/15;类别理解任务从 3/5 提升到 5/5
- ✅ 工程判断:明确了分层控制的适用场景,也在真机上看到了论文 Limitations 中提到的规划器与 VLA 之间的反馈问题
技术栈一览
- 🦾 硬件:Franka FR3、Robotiq 2F-85、Intel RealSense D405 × 2
- 🧠 模型:π0.5 VLA、DeepSeek 大模型规划器
- 🔧 框架:Harness VLA / RPent、手眼标定、像素反投影
延伸阅读
- Harness VLA 论文
- 当机械臂学会"看"和"听":基于 GLM-4V 与 SAM 的智能机械臂系统(2023 年的大模型控制机械臂)
- 具身智能协同落地实战:基于云边端协同的多机器人 Agent 框架
Comments